 por
En una prueba anterior con Claude Code hice la misma pregunta sobre un backend real 21 veces. Ninguna respuesta fue completa. Desde entonces, me interesa menos que un asistente dé una explicación convincente y más lo que se dejó sin mirar. Con Codex frente a Claude Code haría exactamente esa distinción: no basta con que el resultado suene bien.
Dos asistentes reciben el mismo error. Uno cambia cinco líneas y pasa la prueba; el otro aprovecha para ordenar medio módulo. Tal vez ambos tengan razón, pero si queríamos arreglar el error antes de comer, la forma de trabajar importa tanto como el modelo. En septiembre de 2026 los dos pueden leer un repositorio, editar archivos y ejecutar comandos. Tampoco es justo decir que uno es «el de la terminal» y el otro «el del editor»: ambos tienen varias formas de uso.
Primero, no estamos comparando dos modelos fijos
Claude Code puede trabajar con Sonnet u Opus y permite ajustar el esfuerzo. Codex también ofrece distintos modelos y niveles de razonamiento según la cuenta y el entorno. Si alguien dice «Codex gasta menos» o «Claude programa mejor» sin indicar qué modelo utilizó, qué tarea hizo y con qué permisos, a mí me falta la mitad de la comparación. Los hilos de usuarios son útiles para encontrar problemas, pero abundan los veredictos opuestos incluso dentro de una misma conversación.
Hay una queja detrás de muchas de esas discusiones que sí me parece útil: algunos usuarios encuentran que Claude entiende antes lo que querían hacer, pero luego se sale del encargo y les deja un diff demasiado grande. Otros prefieren la implementación de Codex y usan Claude para revisar el plan. También se describe el flujo inverso. No sacaría de ahí una personalidad fija para cada herramienta; miraría qué se ha cambiado fuera del objetivo y no sólo si el test termina en verde.
Además, el asistente no es sólo el modelo. Claude Code carga instrucciones como CLAUDE.md; Codex utiliza AGENTS.md. Si uno conoce la arquitectura y los comandos de prueba y el otro entra sin contexto, el resultado no nos dice mucho sobre su capacidad. Mantendría en ambos las mismas reglas esenciales: cómo instalar dependencias, qué prueba ejecutar y qué carpetas no tocar. No pegaría sin más cien líneas de un archivo en el otro; unas instrucciones enormes también pueden estorbar.
Un cambio pequeño revela más que una demo espectacular
Si tuviera que elegir para un proyecto, empezaría por un fallo de autenticación que aparece sólo al caducar la sesión. Les daría el mismo commit, el test que falla y el mismo objetivo: corregirlo sin rehacer el sistema de usuarios. Antes de aceptar nada, miraría el diff. ¿Han tocado sólo lo necesario? ¿Han añadido una prueba que detecta el error? ¿Han ejecutado esa prueba o sólo dicen que lo han hecho? ¿Han cambiado una comprobación de seguridad para que pase el test?
Aquí suelen aparecer diferencias prácticas. Un agente puede investigar más de la cuenta; otro puede acertar deprisa pero dejar un caso límite. Ninguno gana por escribir un plan muy convincente. También conviene fijarse en cómo explica el bloqueo: «no pude ejecutar el test porque falta la base de datos» es útil; «todo listo» en esa situación no lo es.
Para una comparación limpia, abriría dos copias del mismo repositorio —por ejemplo, con git worktree— y les daría el mismo encargo. No los dejaría editar la misma carpeta a la vez. En cada copia registramos el modelo, el esfuerzo, los permisos y los comandos que llegaron a ejecutar. Luego pasamos nosotros la misma prueba de aceptación y revisamos el diff. Una sola tarea tampoco dicta sentencia: repetiría al menos un bug, un cambio entre varios módulos y una tarea de explicación o revisión.
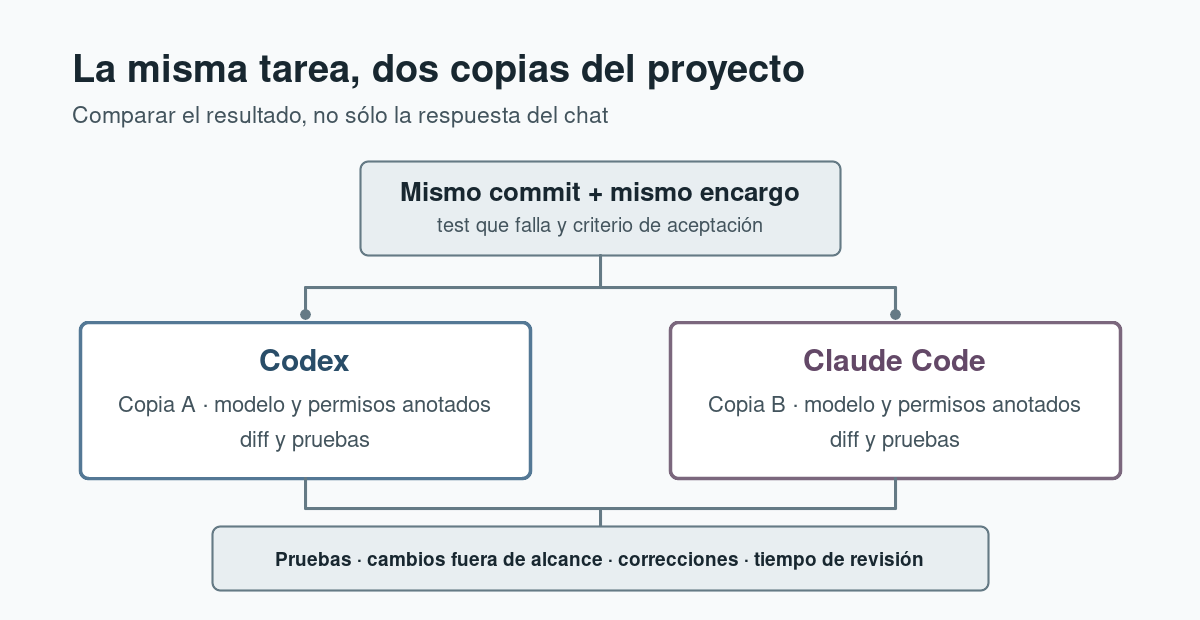
El esquema propone un método de comparación; no representa pruebas realizadas para esta entrada.
Si queremos una segunda lectura del cambio, Codex incluye /review: permite revisar modificaciones sin editarlas. Podemos usarlo sobre un commit o sobre lo que aún no hemos confirmado. Es útil para que nos señale riesgos, pero la revisión no demuestra que el programa funcione; seguimos necesitando ejecutar las pruebas y leer las partes sensibles. También podemos pedir una revisión a Claude Code, dejando explícito que sólo informe y no cambie archivos. En ambos casos conviene darle el diff y el comportamiento esperado, no una pregunta vaga como «¿está bien?».
Permisos: lo que puede hacer cada agente
Al trabajar en nuestro ordenador, ninguno debería tener carta blanca por ser «bueno programando». Codex tiene modos de aislamiento y aprobación configurables; Claude Code también tiene modos y reglas de permisos. La configuración efectiva importa más que el nombre del producto. Antes de soltarle una tarea, comprobaría qué puede escribir, si puede salir a internet, ejecutar comandos o actuar fuera del repositorio. Más aún si hay claves, un VPS de producción o una base de datos real cerca.
Para una prueba de este tipo usaría un repositorio de trabajo o una copia desechable, tests locales y ningún secreto de producción. Si hace falta levantar servicios, lo dejaría escrito en la petición. No daría permisos completos para evitar una confirmación molesta; tampoco compararía una ejecución sin acceso a dependencias con otra que sí pudo instalarlas.
¿Y el coste? La respuesta corta engaña
No basta con contar tokens de la respuesta. Puede haber lecturas de archivos, resultados de herramientas, contexto que se repite, intentos fallidos y agentes auxiliares. Los planes de suscripción tienen límites distintos de la facturación por API; sus barras tampoco son una unidad común para comparar productos. Un modelo que parece barato por petición puede salir caro si tenemos que repetirla tres veces.
Yo apuntaría cuatro cosas por tarea: si quedó resuelta, cuántas correcciones hubo que pedir, cuánto tardamos en revisar el cambio y qué uso marcó cada herramienta. El tiempo humano no aparece en /usage, pero para quien programa es el dato que puede inclinar la balanza. Si los dos resuelven bien, entonces sí merece comparar límites del plan y precio vigente. Hacer la prueba con ambos configurados en su máximo esfuerzo tampoco representa necesariamente cómo trabajaríamos todos los días.
Una combinación que se comenta bastante es dejar que uno implemente y pedir al otro una revisión independiente. Puede descubrir un error, pero no lo convertiría en ritual para cada cambio: duplica trabajo, puede llevar código a otro proveedor y una revisión automática no sustituye a las pruebas. Para una migración o una modificación delicada puede compensar. Para cambiar un texto en la interfaz, probablemente no.
También se repite el consejo de usar siempre el máximo esfuerzo. No lo tomaría como regla: hay tareas en las que sólo añade espera y consumo, y otras en las que evita varios intentos fallidos. La única forma razonable de saberlo es comparar el trabajo terminado, no el número de mensajes ni lo impresionante que parece la explicación.
Cuál elegiría según el trabajo
Si ya tenemos un flujo cómodo en una de las herramientas, cambiar de asistente sólo porque esta semana alguien publicó una tabla de benchmarks no suele arreglar nada. Probaría la otra cuando la actual se atasca de forma repetida en un tipo de tarea concreto, cuando sus límites me cortan el trabajo o cuando necesito una revisión con una mirada distinta. Mantendría las dos únicamente si esa segunda mirada me ahorra más tiempo del que cuesta gestionarlas.
También se puede mejorar el resultado sin cambiar de producto: dar el test que falla, acotar la zona sospechosa, definir qué significa «terminado» y revisar los permisos. Si lo que nos molesta de Claude Code es que Opus habla demasiado, eso tiene un remedio distinto de sustituirlo por Codex. No mezclaría una molestia con la interfaz con un fallo al programar.
No voy a recomendar un ganador para todos los repositorios sin haber hecho esa prueba. Sí elegiría con algo mejor que el entusiasmo del día: el mismo problema, el mismo punto de partida y los cambios delante. Si habéis usado los dos, me interesa especialmente saber qué tarea resolvió mejor cada uno, no sólo cuál os gustó más al abrirlo.