 por
Que podamos descargar un modelo de inteligencia artificial no significa que sea software libre ni que todo su funcionamiento esté abierto. A veces tenemos los pesos, pero no los datos de entrenamiento. En otros casos vemos el código de la aplicación, aunque el modelo sólo puede utilizarse bajo unas condiciones que prohíben determinados usos.
El problema es que utilizamos «modelo abierto», «pesos abiertos» y «código abierto» como si fueran la misma cosa. En un programa tradicional ya tenemos que revisar el código y la licencia. En una IA aparecen más piezas, y cada una puede tener unos permisos distintos.
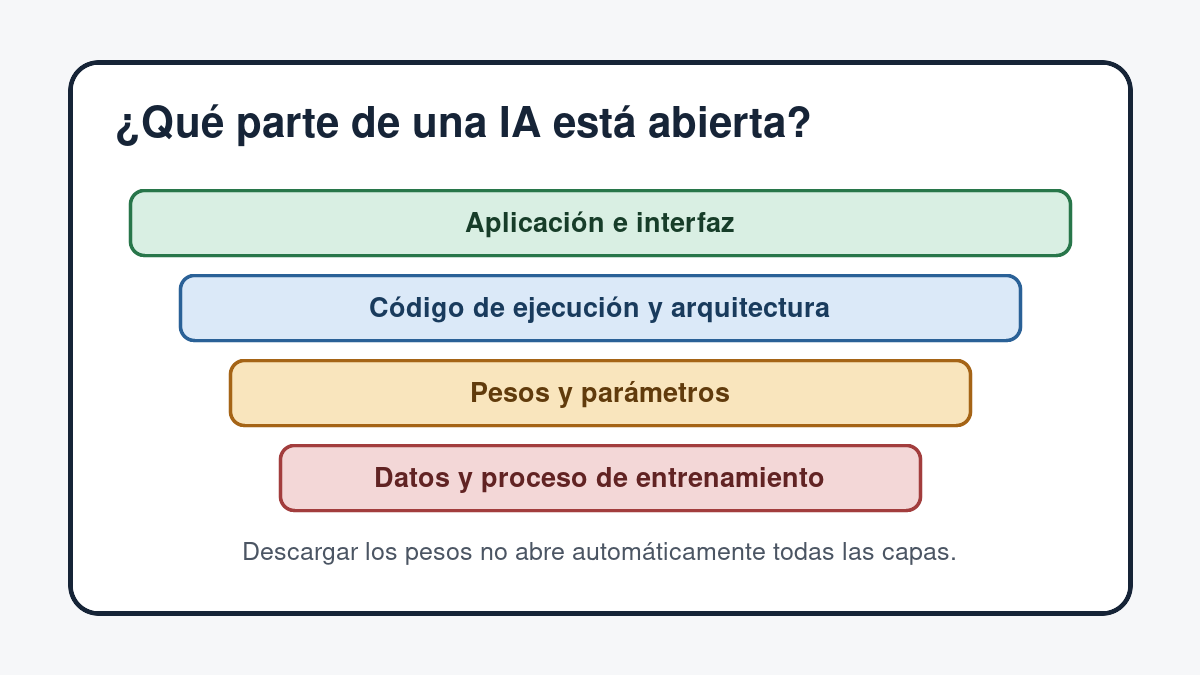
Un modelo no es una sola pieza
Cuando ejecutamos una IA local vemos una aplicación y descargamos un archivo de varios gigabytes. Debajo hay, como mínimo, cuatro capas que conviene separar:
- La aplicación o interfaz: el programa desde el que escribimos, administramos modelos o conectamos herramientas.
- El código de ejecución: la arquitectura, el motor de inferencia, el tokenizador y las bibliotecas necesarias para producir una respuesta.
- Los pesos: los parámetros obtenidos durante el entrenamiento. Son los archivos grandes que normalmente descargamos.
- La información de entrenamiento: procedencia y selección de los datos, código de entrenamiento, configuración, filtros y métodos de evaluación.
Podemos tener una interfaz libre que llama a un modelo propietario mediante una API. También un motor libre que ejecuta pesos descargables con una licencia propia. Incluso puede publicarse el código de entrenamiento sin publicar los pesos finales. Decir únicamente que «la IA es abierta» oculta todas esas diferencias.
Qué significa tener los pesos abiertos
En la práctica, pesos abiertos suele indicar que podemos descargar los parámetros y ejecutar el modelo en nuestro ordenador o servidor. Esto ya aporta bastante: permite trabajar sin enviar cada petición a una empresa, conservar una versión concreta y estudiar parte de su comportamiento.
Sin embargo, el archivo descargable no explica por sí solo cómo se obtuvo. Tampoco nos da automáticamente permiso para modificarlo, redistribuirlo, utilizarlo comercialmente o emplearlo para cualquier finalidad. Para conocer esos derechos debemos leer su licencia, no la etiqueta de la página de descarga.
Hay licencias de modelos que permiten muchos usos, pero añaden límites por número de usuarios, sector, finalidad o tamaño de la empresa. Esos pesos pueden estar disponibles públicamente, aunque una restricción de uso impide tratarlos como software libre o código abierto en el sentido habitual: una licencia libre no puede decidir que unas personas o unas actividades sí pueden utilizar el programa y otras no.
Código visible tampoco significa código abierto
Un repositorio público sólo demuestra que podemos leer el código. Si no incluye licencia, se aplican por defecto los derechos de autor y no tenemos permiso general para copiarlo, modificarlo y redistribuirlo. GitHub lo explica de forma bastante directa en su documentación sobre licencias.
También existen licencias source available: permiten consultar el código y a veces modificarlo para uso interno, pero restringen competir con el proveedor, ofrecerlo como servicio o utilizarlo en determinados ámbitos. Pueden ser útiles y transparentes, pero no debemos llamarlas libres si no conceden las libertades de uso, estudio, modificación y distribución.
La diferencia no es un detalle filosófico. Determina si una comunidad puede continuar el proyecto cuando la empresa cambia de rumbo, si podemos adaptar el programa a otra necesidad o si una distribución Linux puede incluirlo sin aceptar condiciones adicionales.
Qué pide la definición de IA de código abierto
La Open Source AI Definition 1.0 de la Open Source Initiative intenta trasladar estas libertades a un sistema de aprendizaje automático. No se limita a que los pesos puedan descargarse. Pide libertad para usar, estudiar, modificar y compartir el sistema, además de la forma preferida para realizar cambios.
Para ello distingue tres elementos: información suficiente sobre los datos, el código completo utilizado para entrenar y ejecutar el sistema, y los parámetros del modelo. No exige necesariamente publicar cada dato de entrenamiento cuando no puede compartirse, pero sí describir su procedencia, selección, tratamiento y cómo obtener los conjuntos que sean accesibles.
Es una definición exigente y todavía habrá debates sobre cómo aplicarla a cada modelo. Lo importante para nosotros es que ofrece una pregunta mejor que «¿puedo descargarlo?»: ¿tenemos lo necesario y los permisos necesarios para comprenderlo, modificarlo y compartirlo?
Cómo revisar un modelo antes de llamarlo abierto
No hace falta realizar una auditoría jurídica completa para describirlo con más precisión. Podemos seguir este orden:
- Localizar la licencia de los pesos. Comprobamos si permite uso comercial, modificación y redistribución, y si introduce límites por finalidad o tipo de usuario.
- Revisar la licencia del código. El motor, la interfaz y el modelo pueden utilizar licencias diferentes. Una licencia MIT del cliente no se extiende por arte de magia a los pesos.
- Buscar el código y la configuración de entrenamiento. Una arquitectura publicada no equivale a disponer del proceso que produjo el modelo.
- Comprobar la información sobre los datos. Interesa saber de dónde salen, cómo se filtraron y qué limitaciones reconocen sus autores.
- Separar ejecución local y libertad. Que funcione sin internet mejora nuestro control y privacidad, pero no cambia por sí solo la licencia.
- Ver qué podemos redistribuir. Poder convertir o ajustar un modelo no implica poder compartir el resultado.
Una forma más honesta de hablar de estos modelos
Si sólo conocemos una parte, podemos nombrar exactamente esa parte: «modelo con pesos descargables», «motor de inferencia libre», «interfaz de código abierto conectada a una API propietaria» o «código visible con restricciones comerciales». Son expresiones menos vistosas, pero ayudan mucho más a decidir.
La definición de software libre de GNU sigue siendo una buena base: ejecutar, estudiar, modificar y compartir. En la inteligencia artificial no desaparecen esas libertades; simplemente tenemos que comprobarlas en más sitios.
La próxima vez que un modelo se presente como abierto, merece la pena bajar un poco en su página y leer qué se entrega realmente. Normalmente la respuesta interesante no está en el botón de descarga, sino en la licencia y en las piezas que faltan.