 por
En mi comparativa anterior de Opus y Sonnet hice la misma pregunta a Claude Code 21 veces. Subir el esfuerzo no siempre mejoró la respuesta. Aquello era con modelos anteriores, pero me dejó una desconfianza bastante sana hacia la receta de ponerlo todo en «Max» y esperar que salga mejor.
Con Opus 5 se mezclan dos quejas: se come la cuota y habla demasiado. Podemos pedirle que arregle un fallo pequeño y acabar con media aplicación leída y una narración interminable. Pero una respuesta pesada y una sesión cara no son exactamente el mismo problema. Para esta entrada no hay una repetición de aquellas 21 pruebas con Opus 5, así que no voy a declararlo peor que 4.8 a partir de un hilo de Reddit. Allí hay quien ha vuelto a 4.8 y quien resuelve mejor con 5. Lo útil es averiguar qué ocurre en nuestro proyecto.
Claude Code es de Anthropic; el logotipo se usa aquí para identificar la herramienta.
Antes de ahorrar, mira dónde se va el uso
Abrimos /usage. Si usamos Pro o Max, las barras del plan son lo que nos interesa para saber cuánto margen nos queda. La cifra en dólares del apartado «Session» estima cuánto habría costado a precio de API; no es otra factura por esa sesión. Si pagamos por API, en cambio, hay que consultar también la facturación real del proveedor. Y ninguna de esas cifras mide el tiempo que perdemos revisando un cambio malo.
En versiones recientes, /usage señala además si han pesado especialmente el contexto largo, los fallos de caché, los subagentes o alguna herramienta MCP. Yo miraría eso antes de culpar al modelo. Una petición de «arregla el login» puede disparar búsquedas por medio proyecto; una conversación de horas arrastra historial; una revisión con varios agentes multiplica el trabajo aunque la respuesta final ocupe cuatro líneas.
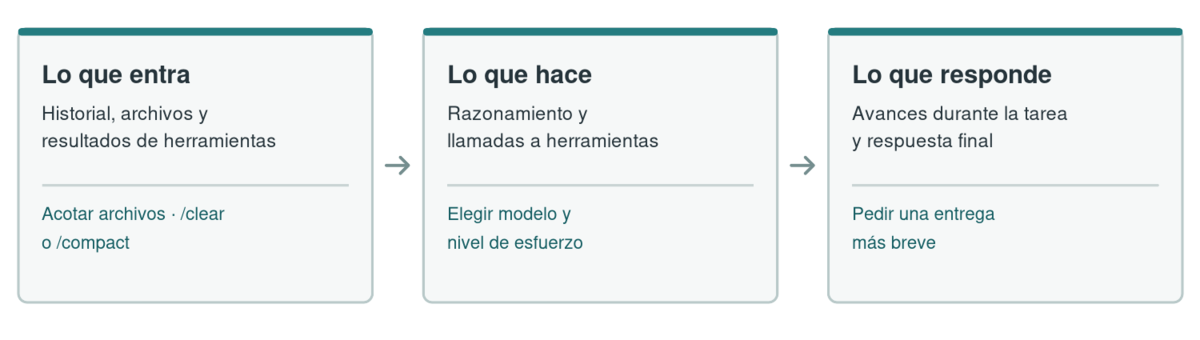
Una respuesta breve sólo reduce la última parte del esquema. No evita que Claude haya leído y procesado demasiado antes de escribirla.
Si cambiamos de asunto, /clear evita seguir cargando una conversación que ya no sirve. Si aún estamos con el mismo problema, /compact puede conservar sus decisiones importantes. No usaría ninguno a cada rato: reconstruir el contexto también tiene un coste, y perder una decisión útil nos obliga a explicarla de nuevo.
Quitarle la verborrea a Opus 5
Anthropic reconoce que las respuestas finales de Opus 5 tienden a ser más largas que las de versiones anteriores. Bajar /effort no garantiza que hable menos; ese ajuste cambia el trabajo de razonamiento, no es un control de longitud. Si el problema es el texto que vemos, empezaría por el estilo de salida Concise: en Claude Code 2.1.237 o posterior se elige con /config → «Output style». Mantiene las advertencias y los errores, pero quita buena parte del preámbulo y de la narración. No usaría el antiguo comando /output-style, que ya no existe en las versiones actuales.
El estilo se guarda para el proyecto y afecta a la conversación principal, no necesariamente a lo que gastan otros agentes. Tampoco promete recortar el razonamiento interno. Por eso no esperaría una caída proporcional de la barra de uso sólo porque la pantalla quede más limpia.
Cuando sólo nos molesta la entrega final, basta con pedir algo más preciso. Por ejemplo:
Al terminar, dime qué archivos has cambiado, qué prueba has ejecutado y qué queda pendiente. No me narres cada comando, pero no omitas errores ni digas que has probado algo que no has ejecutado.
Me parece mejor que «sé breve» a secas: seguimos recibiendo lo necesario para revisar el trabajo. Si repetimos la petición en todos los proyectos, podemos convertirla en una instrucción corta; no hace falta llenar CLAUDE.md de reglas de estilo. Ese archivo tiene más valor para comandos, convenciones y peculiaridades del repositorio.
Evitar trabajo que no habíamos pedido
Opus 5 puede interpretar «hazlo bien» como permiso para explorar más, refactorizar alrededor o verificar varias veces el mismo cambio. A veces viene bien; para corregir una condición concreta, no. La petición siguiente le da un límite útil sin prohibirle investigar:
El test de caducidad de sesión falla en
tests/auth. Revisa primero ese test ysrc/auth. Corrige ese comportamiento, ejecuta la prueba afectada y no refactorices otras zonas. Si necesitas salir de esos archivos para resolverlo, dime por qué.
Las rutas son un ejemplo. Si no conocemos el origen del fallo, inventar un perímetro tan estrecho puede empeorar el resultado. Pero si ya tenemos una pista, no tiene sentido volver a pagar por una exploración general. Tampoco pediría «que tres agentes lo revisen» para cada cambio: la revisión independiente merece la pena en una migración o una modificación delicada, no para renombrar una variable. Podemos solicitar primero la prueba afectada y ampliar a toda la suite si el cambio lo justifica.
Otra fuente de gasto está en las instrucciones permanentes. Si CLAUDE.md incluye páginas de documentación que sólo sirven para una tarea ocasional, Claude las recibe una y otra vez. Dejaría ahí lo imprescindible y llevaría el procedimiento específico a una skill o a un archivo que se abra cuando haga falta. /context nos ayuda a ver si las herramientas MCP están ocupando espacio; no desactivaría una herramienta útil sólo para mejorar un número.
¿Sonnet 5 o Opus 5? No mires sólo el precio por token
Sonnet 5 tiene un precio de API por token inferior al de Opus 5. Eso no prueba que una tarea completa salga más barata con Sonnet. Si resuelve a la primera una corrección bien delimitada, estupendo. Si necesita tres intentos y después hay que reparar la prueba, la comparación cambia. En una suscripción tampoco podemos convertir directamente el precio de la API en minutos de cuota: el plan tiene sus propios límites.
Mi punto de partida sería Sonnet para cambios acotados y explicaciones, y Opus cuando el fallo atraviesa varios módulos, hay decisiones ambiguas o Sonnet ya ha repetido el mismo error. Se cambia con /model sonnet o /model opus. Hay también /model opusplan, que usa Opus para planificar y Sonnet para ejecutar; merece probarlo cuando la dificultad está en decidir qué hacer, pero no asegura ni menos uso ni mejor código. Después hay que revisar la implementación, no quedarse con lo convincente que sonaba el plan.
Con /effort medium podemos comprobar si una tarea sencilla queda igual de bien con menos trabajo interno. Si deja casos sin cubrir, volvemos a high. No pondría low a una operación delicada sólo por ahorrar: corregir después un fallo puede consumir más que haber pensado un poco más al principio. Los niveles tienen calibraciones distintas según el modelo, así que medium en 4.8 y en 5 no son una comparación idéntica.
¿Y si Opus 4.8 funciona mejor para mí?
Puede ocurrir. Las pruebas del fabricante muestran mejoras de Opus 5 en varias tareas, pero no sustituyen nuestro proyecto. Para decidirlo usaría dos o tres trabajos que ya conocemos: un bug con test, un cambio en varios archivos y una tarea donde antes tuvimos que corregir la salida. Partiría del mismo commit en copias separadas, escribiría la misma petición y fijaría el modelo con /model claude-opus-5 y /model claude-opus-4-8, sin confiar en el alias opus, que puede cambiar. También anotaría el esfuerzo, los permisos y las herramientas disponibles.
Después miramos el resultado: pruebas que pasan, cambios que sobran, errores que quedan, vueltas que hemos tenido que dar y uso registrado. Si una versión escribe menos pero deja un bug, no ha ganado. Si otra gasta más tokens y nos evita media hora de revisión, tampoco es justo llamarla peor sin más. Y si 4.8 resuelve mejor vuestras tareas, no hay obligación de usar el número más alto.
Las cifras de aquella comparativa con modelos anteriores no se pueden trasladar a Opus 5. Si hacéis una prueba parecida, contadnos con qué tarea y configuración: ahí empieza una comparación que de verdad ayuda.