 por
GPT-6 ya ha llegado a Codex y el modelo que más fácil va a confundir es GPT-6 Sol. No es el sustituto barato que sólo sirve para corregir una línea ni tampoco el modelo más grande de la familia. OpenAI lo coloca en medio: debería conservar bastante capacidad para trabajar sobre un repositorio real, pero con una velocidad y un coste que permitan utilizarlo todos los días.
Sobre el papel suena bien. El problema es que las fichas de lanzamiento siempre suenan bien. Para no quedarme en la tabla de contexto y precios preparé una prueba pequeña, pero con varias trampas bastante habituales: una caché con TTL, acceso desde varios hilos, cargas duplicadas y errores que no deben quedarse guardados. Lo ejecuté con Sol en esfuerzo Medium y, cuando terminó, añadí tres pruebas ocultas que el modelo no había visto.
Qué es GPT-6 Sol y dónde queda Astra y Luna
La familia GPT-6 se divide en Astra, Sol y Luna. El nombre no indica una versión anterior o posterior, sino el lugar que ocupa cada modelo. Astra es el que OpenAI reserva para los trabajos más difíciles, Sol busca el equilibrio entre razonamiento, rapidez y consumo, y Luna está pensado para tareas de mucho volumen donde importa más la eficiencia.
Para programar con Codex, Sol es probablemente el importante. La propia documentación de generación de código lo recomienda como modelo general para la mayoría de trabajos. Eso no significa que sea el mejor en cada tarea. Significa que debería ser el que podemos dejar seleccionado sin preguntarnos cada cinco minutos si estamos malgastando el modelo grande.
GPT-6 Sol admite un contexto de hasta 1.050.000 tokens y una salida máxima de 128.000. También ofrece los niveles de esfuerzo none, low, medium, high, xhigh y max. Medium viene como punto de partida sensato. Tener más de un millón de tokens no convierte en buena idea volcar un monorepo entero en la conversación: cuanto más ruido entra, más fácil es que el modelo dedique tiempo a piezas que no importan.
La prueba: arreglar una caché sin decirle dónde estaba el fallo
Preparé un repositorio Python deliberadamente corto. La clase TTLCache parecía funcionar, pero tenía tres problemas:
- Una entrada seguía siendo válida justo en el instante de caducidad.
- Dos hilos podían ejecutar a la vez el mismo
loaderpara una clave. - Proteger todo con un único bloqueo podía solucionar lo anterior a cambio de impedir que dos claves distintas se cargasen en paralelo.
No le enumeré estas soluciones. El archivo ISSUE.md describía los síntomas y este fue el prompt completo:
Lee ISSUE.md, corrige el problema con el menor alcance razonable, añade o ajusta pruebas sólo si protegen el comportamiento y ejecuta la suite. No modifiques ISSUE.md. Al terminar resume los cambios y las pruebas ejecutadas.
Usé GPT-6 Sol con esfuerzo Medium, sin reglas especiales del proyecto y con permisos de escritura limitados al repositorio. El proceso tardó aproximadamente 75 segundos y consumió 15.415 tokens. No es una prueba de rendimiento universal, pero sí una ejecución que se puede revisar: mismo código, mismo prompt y una salida concreta.
Qué hizo bien
Lo primero fue corregir la frontera del TTL. El código usaba now > expires_at, de modo que una entrada aún podía devolverse cuando ambos valores eran iguales. Sol lo cambió a now >= expires_at tanto en la lectura como en la limpieza de entradas.
La parte interesante fue la concurrencia. En lugar de mantener un bloqueo durante la llamada al cargador, añadió un diccionario de trabajos pendientes por clave. El primer hilo crea un Future y ejecuta la carga; los demás esperan ese mismo resultado. Dos claves diferentes conservan la posibilidad de cargar en paralelo. Es una solución bastante más fina que envolver get_or_load() entero en un Lock.
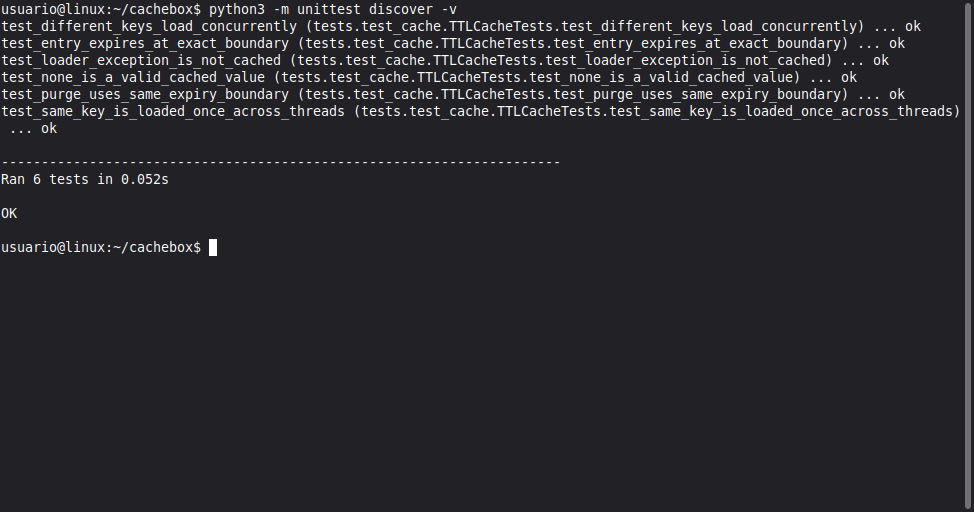
También protegió con el mismo bloqueo las operaciones de lectura, escritura y purga. Añadió dos pruebas visibles: una comprueba que dos claves pueden cargarse a la vez y otra que una excepción del cargador no queda almacenada. Al terminar ejecutó la suite y dejó 6 de 6 pruebas correctas.
Las pruebas ocultas
Una suite verde sólo demuestra que el modelo ha satisfecho las pruebas que conoce. Después de cerrar su ejecución añadí tres casos sin enseñárselos:
- Cuatro hilos piden la misma clave, el cargador falla y todos deben recibir la misma excepción. Un intento posterior debe poder recuperarse.
- Una entrada con TTL cero debe nacer caducada.
- Las lecturas y
purge_expired()deben poder convivir desde varios hilos sin corromper el diccionario.
Los tres pasaron. Esto no convierte el parche en una biblioteca de caché lista para producción, pero sí confirma que la idea central no estaba escrita únicamente para complacer las pruebas añadidas por el propio modelo.
Dónde todavía se nota la ceremonia de un agente
Sol no fue perfecto. Primero intentó ejecutar python, descubrió que ese binario no existía y pasó a python3. No es grave, pero una lectura rápida del entorno habría evitado el intento. Al final quiso borrar __pycache__ con rm -rf; la protección de la herramienta rechazó el comando y buscó una alternativa más acotada.
Ese detalle resume bastante bien mi primera impresión. El trabajo importante fue correcto y no se perdió en una reescritura enorme, pero aún aparecen pequeños pasos ceremoniales que no aportan nada al arreglo. Tampoco comentó una sutileza del uso de Future.set_exception(): en diseños más complejos conviene vigilar las excepciones no recuperadas cuando no existe ningún consumidor. No afectó a las pruebas de este ejercicio, aunque habría agradecido que lo mencionase.
Medium parece el punto de partida, no una regla
Con Sol no empezaría por Max. Para una corrección acotada, Medium ya leyó el problema, modificó dos archivos y comprobó el resultado sin ampliar el alcance. Subir el esfuerzo no sólo añade inteligencia: también puede añadir búsquedas, alternativas y cambios que nadie había pedido.
| Trabajo | Esfuerzo que usaría |
|---|---|
| Explicar código, localizar un archivo o hacer un cambio mecánico | Low o Medium |
| Corregir un bug con pruebas y alcance claro | Medium |
| Revisar una arquitectura o seguir un fallo entre varios servicios | High o xHigh |
| Incidente difícil, migración grande o revisión final crítica | xHigh o Max, con límites claros |
Las primeras experiencias con Sol son bastante dispares precisamente por esto. En tareas bien delimitadas se repiten tres comentarios: va rápido, consume menos cuota de la esperada y suele llegar a una implementación útil. Cuando el encargo es abierto, otros usuarios lo ven perezoso, demasiado literal o dispuesto a meterse por una tangente. No son dos modelos distintos; son encargos y niveles de esfuerzo distintos.
Precio y contexto: el millón de tokens tiene letra pequeña
En la API, GPT-6 Sol cuesta 2 dólares por millón de tokens de entrada, 0,20 dólares por la entrada en caché y 10 dólares por millón de tokens de salida en el tramo estándar. A partir de 272.000 tokens de entrada, la petición completa entra en un tramo más caro: la entrada se duplica y la salida pasa a costar una vez y media más. La ficha oficial del modelo mantiene las cifras actualizadas.
Esto importa porque Codex no consume sólo el texto que escribimos. También entran instrucciones, resultados de herramientas, partes del repositorio y el historial útil de la tarea. Un contexto enorme sirve para no cortar una investigación larga, pero no sale gratis. Antes de subir el esfuerzo prefiero limpiar el encargo: indicar la ruta relevante, describir el fallo observable, limitar el alcance y pedir una prueba concreta.
El prompt que usaría para trabajar con Sol
Reproduce primero el fallo y localiza su causa.
Corrige el problema con el menor alcance razonable.
No cambies interfaces públicas ni archivos ajenos salvo que sea imprescindible.
Añade pruebas para el comportamiento que estaba roto.
Ejecuta la suite relacionada y revisa el diff antes de terminar.
Si encuentras otro problema, descríbelo aparte; no lo arregles sin necesidad.
No es un conjuro. Lo que hace es separar diagnóstico, cambio y verificación, además de frenar la tendencia a “mejorar” piezas cercanas. En repositorios reales esa última línea suele ahorrar más tokens que cualquier truco de configuración.
¿Usaría GPT-6 Sol en Codex?
Sí, como modelo por defecto para trabajo diario. En esta prueba Medium encontró una solución correcta, mantuvo el cambio razonablemente pequeño y superó tres comprobaciones que no conocía. No veo una razón para saltar directamente a Astra o Max cuando el problema está bien definido.
Eso tampoco demuestra que Sol sea mejor que cualquier modelo anterior en un proyecto grande. Una corrección de 75 segundos mide disciplina local, no planificación durante dos horas ni comprensión de un monorepo. Mi conclusión de momento es más sencilla: Sol parece bueno cuando le damos un problema concreto y le exigimos demostrar la solución. Si el encargo es ambiguo, el millón de tokens sólo le ofrece un bosque más grande en el que perderse.
Seguiré probándolo con tareas más largas. Si vosotros ya lo estáis usando, podéis dejar en los comentarios el tipo de proyecto, el nivel de esfuerzo y dónde habéis notado el cambio; eso resulta bastante más útil que decir simplemente que un modelo “es mejor” o “es peor”.